3 Premiers pas avec Pandas
Dans le cours DS&SC-4, nous avons étudié NumPy, dont l’objet principal, le ndarray, permet de stocker et de manipuler efficacement des tableaux homogènes. Cet objet, idéal pour les valeurs numériques (et donc la mise en œuvre de schémas d’approximation), montre ses limites dès qu’il s’agit de données variées (catégories, libellés, dates, texte).
En analyse de données, on organise souvent l’information sous forme de lignes (individus) et de colonnes (variables), qui ne sont pas nécessairement numériques. Exemples :
- dans l’automobile, chaque individu est une voiture, avec des caractéristiques telles que la puissance du moteur, les dimensions, la marque, le modèle, la couleur, etc. ;
- en grande distribution, chaque individu est un produit, avec des informations comme le prix et la catégorie ;
- dans le secteur bancaire, chaque individu est une personne, avec des informations comme le salaire moyen, l’âge et les mensualités d’un prêt.
Nous avons donc besoin d’un outil capable de :
- représenter les données au format individus × variables ;
- manipuler des types hétérogènes ;
- lire et écrire des données depuis diverses sources.
C’est exactement le rôle de la bibliothèque pandas.
Objectifs d’apprentissage
- Identifier les objets de base de
pandas(Series, DataFrame) et leur lien avecNumPy. - Lire et écrire des données (CSV) et comprendre les types hétérogènes.
- Sélectionner, filtrer, trier, agréger et fusionner des données.
- Calculer et interpréter des statistiques descriptives (describe, moyennes, écarts-types, quantiles).
- Visualiser des données avec
Matplotlib,Seaborn,Plotlyet choisir une représentation adaptée.
3.1 Importation de pandas
Une fois pandas installé, vérifions que tout fonctionne correctement. La communauté Python a adopté quelques conventions de nommage pour les modules courants :
Définissons quelques options par défaut pour la création des figures :
plt.rcParams['font.size'] = 15
plt.rcParams['figure.figsize'] = (15, 7) # Taille par défaut des figures
# plt.style.use('ggplot') # set ggplot style


sns.set_theme(context = "notebook", # paper, notebook, talk, poster
              style = "darkgrid", # ticks, whitegrid, darkgrid, white, dark
              palette = "pastel", # None, Set2, husl, deep, muted, bright, pastel, dark, colorblind
              rc = {"axes.spines.right": False,
                    "axes.spines.top": False}
            )
Quelques remarques sur les bibliothèques de visualisation. Trois options populaires se distinguent : Matplotlib, Seaborn et Plotly, chacune avec ses forces et particularités.
- Matplotlib est la bibliothèque de base en Python. Elle offre une grande flexibilité et un contrôle fin de tous les aspects des graphiques, des tracés simples aux visualisations complexes. Elle est idéale pour une personnalisation poussée et un large éventail de types de graphiques. Cette flexibilité s’accompagne toutefois d’une complexité accrue et demande souvent davantage de code.
- Seaborn, construit sur Matplotlib, simplifie la création de graphiques statistiques élégants. Il propose des thèmes et des palettes intégrés qui rendent les visualisations plus attrayantes et informatives. En contrepartie, les personnalisations très spécifiques peuvent être plus limitées.
Avec Matplotlib et Seaborn, les figures sont statiques : toute l’information doit être visible dans la figure, ce qui peut la surcharger. On peut concevoir des visualisations à plusieurs niveaux : un premier niveau « coup d’œil » pour les messages clés, puis des détails supplémentaires. Les visualisations interactives, devenues la norme en dataviz, facilitent cette approche : au survol de la souris, on obtient des informations complémentaires (par exemple, les valeurs exactes).
- Plotly, basé sur JavaScript, permet de créer des visualisations interactives et dynamiques. Il prend en charge les graphiques 3D et les cartes, ce qui le rend très puissant.
3.2 Une analyse complète, en quinze lignes
Ne cherchez pas à comprendre le code de cette section. Il met en œuvre à peu près tout ce que nous verrons pendant les quatre séances : lecture d’un fichier, inspection, création de colonnes, agrégation, visualisation.
L’objectif ici est seulement de voir à quoi ressemble une analyse de données complète, du fichier brut à la conclusion : et de constater qu’elle tient en une quinzaine de lignes. Vous saurez tout écrire d’ici la fin du cours.
Reprenons l’exemple de l’automobile évoqué plus haut. Le fichier voitures.csv décrit 32 modèles testés par le magazine Motor Trend en 1974 : un jeu de données classique en statistique.
3.2.1 1. Lire le fichier
| mpg | cyl | disp | hp | drat | wt | qsec | vs | am | gear | carb | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Mazda RX4 | 21.0 | 6 | 160.0 | 110 | 3.90 | 2.620 | 16.46 | 0 | 1 | 4 | 4 |
| Mazda RX4 Wag | 21.0 | 6 | 160.0 | 110 | 3.90 | 2.875 | 17.02 | 0 | 1 | 4 | 4 |
| Datsun 710 | 22.8 | 4 | 108.0 | 93 | 3.85 | 2.320 | 18.61 | 1 | 1 | 4 | 1 |
| Hornet 4 Drive | 21.4 | 6 | 258.0 | 110 | 3.08 | 3.215 | 19.44 | 1 | 0 | 3 | 1 |
| Hornet Sportabout | 18.7 | 8 | 360.0 | 175 | 3.15 | 3.440 | 17.02 | 0 | 0 | 3 | 2 |
Premier constat, et il est général : les données réelles n’arrivent jamais documentées. Les noms de colonnes sont des abréviations, en anglais, sans unités. Avant toute chose, il faut savoir ce qu’elles désignent :
| Colonne | Signification | Unité |
|---|---|---|
mpg |
consommation | miles par gallon |
cyl |
nombre de cylindres | |
disp |
cylindrée | pouces cubes |
hp |
puissance | chevaux |
wt |
poids | milliers de livres |
qsec |
temps sur le quart de mile | secondes |
am |
boîte de vitesses | 0 = automatique, 1 = manuelle |
Nous n’utiliserons que mpg, cyl et hp.
3.2.2 2. Regarder la forme du jeu de données
32 voitures, 11 caractéristiques
| mpg | cyl | hp | |
|---|---|---|---|
| count | 32.0 | 32.0 | 32.0 |
| mean | 20.1 | 6.2 | 146.7 |
| std | 6.0 | 1.8 | 68.6 |
| min | 10.4 | 4.0 | 52.0 |
| 25% | 15.4 | 4.0 | 96.5 |
| 50% | 19.2 | 6.0 | 123.0 |
| 75% | 22.8 | 8.0 | 180.0 |
| max | 33.9 | 8.0 | 335.0 |
3.2.3 3. Créer une colonne exploitable
La consommation est donnée en miles par gallon : une unité où plus le nombre est grand, moins la voiture consomme. Convertissons-la en litres aux 100 km :
\[ \text{L/100 km} = \frac{235{,}215}{\text{mpg}} \]
| cyl | hp | conso | |
|---|---|---|---|
| Mazda RX4 | 6 | 110 | 11.200714 |
| Mazda RX4 Wag | 6 | 110 | 11.200714 |
| Datsun 710 | 4 | 93 | 10.316447 |
| Hornet 4 Drive | 6 | 110 | 10.991355 |
| Hornet Sportabout | 8 | 175 | 12.578342 |
La plus sobre : Toyota Corolla 6.9 L/100 km
La plus gourmande : Cadillac Fleetwood 22.6 L/100 km
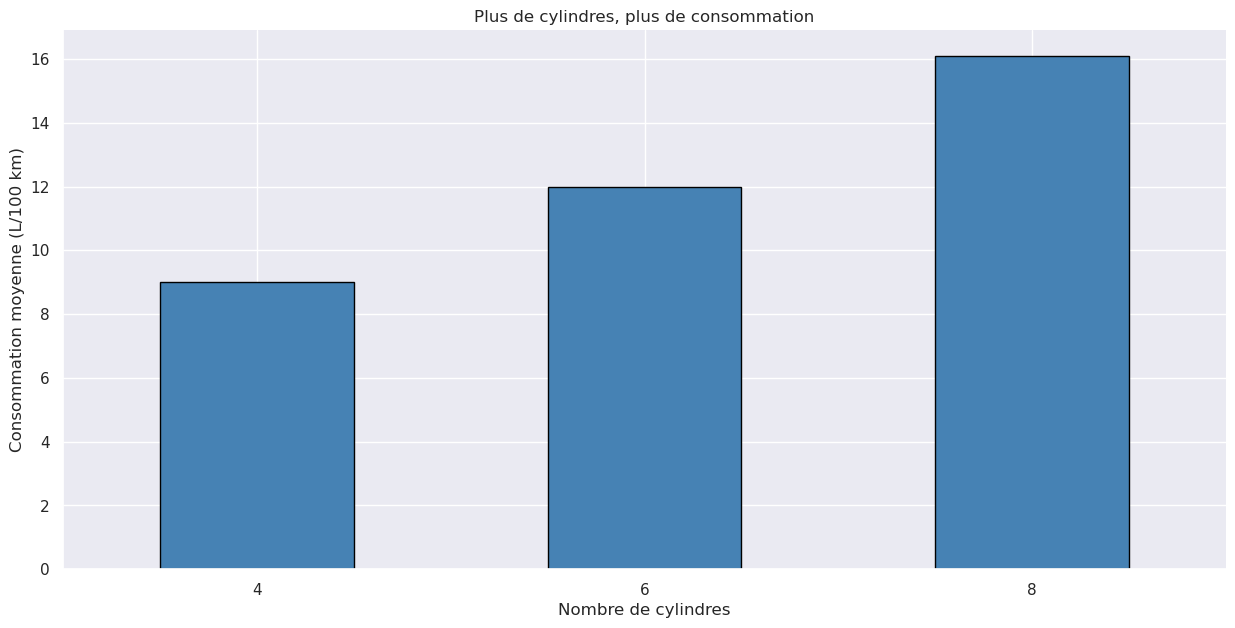
3.2.4 4. Agréger : la consommation dépend-elle du nombre de cylindres ?
| nombre | conso_moyenne | puissance_moyenne | |
|---|---|---|---|
| cyl | |||
| 4 | 11 | 9.0 | 82.6 |
| 6 | 7 | 12.0 | 122.3 |
| 8 | 14 | 16.1 | 209.2 |
3.2.5 5. Visualiser la relation complète
sns.scatterplot(data=voitures, x='hp', y='conso', hue='cyl', palette='viridis', s=120)
plt.xlabel("Puissance (ch)")
plt.ylabel("Consommation (L/100 km)")
plt.title("Puissance et consommation des 32 modèles")
plt.show()

display(Markdown(f"Corrélation entre puissance et consommation : {voitures['hp'].corr(voitures['conso']):.2f}"))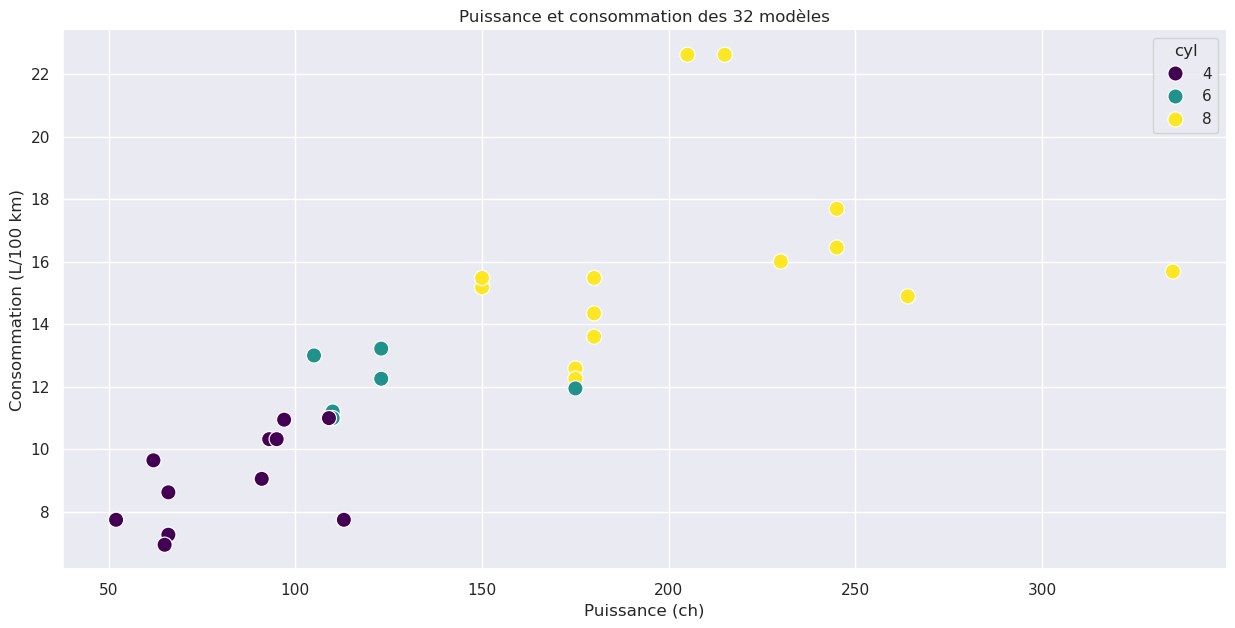
corrélation entre puissance et consommation : 0.76
3.2.6 6. Conclure
Une 4 cylindres consomme en moyenne 9,0 L/100 km, une 6 cylindres 12,0 et une 8 cylindres 16,1 : la consommation augmente de près de 80 % entre les deux extrêmes. Le nuage de points montre que la puissance explique largement ce phénomène : les deux grandeurs sont corrélées à 0,76 : et que le nombre de cylindres n’en est qu’un indicateur commode.
Rien de surprenant pour qui s’intéresse aux voitures. Ce qui doit retenir votre attention, c’est le chemin parcouru : d’un fichier texte de 32 lignes nous sommes arrivés à une affirmation chiffrée et à deux graphiques, en une quinzaine d’instructions.
3.2.7 Ce que nous venons de faire, et où vous l’apprendrez
| Étape | Outil | Où |
|---|---|---|
| Lire un fichier de données | read_csv |
chapitre DataFrames |
| Afficher, décrire, inspecter | head, shape, describe |
chapitre DataFrames |
| Sélectionner des colonnes | df[['a','b']] |
chapitres Series et DataFrames |
| Créer une colonne calculée | df['new'] = ... |
chapitre DataFrames |
| Trouver un extremum | idxmin, idxmax |
chapitre DataFrames |
| Regrouper et agréger | groupby, agg |
chapitre DataFrames |
| Visualiser | plot, seaborn |
tout au long du cours |
| Interpréter | votre tête | cours d’analyse de données |
| Prévoir | - | cours de modélisation |