7 Premières manipulations avec Pandas
7.1 Exercice : premières manipulations de Series
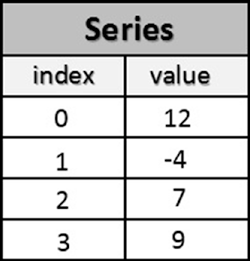
- Construire la Series suivante :
- Modifier la valeur de
valueà 10 pour l’élément en position 3. - Afficher les éléments avec
valuesupérieur à 5. - Modifier la valeur de
valueà 0 pour les éléments avec unvalueinférieur à 5. - Ajouter un élément avec un
valuede 3.5 à la Serie (cet élément doit avoir un label différent). - Modifier les indices de la Serie pour qu’ils soient des lettres de l’alphabet.
0    12
1    -4
2     7
3     9
dtype: int640 12
1 -4
2 7
3 10
dtype: int640 True
1 False
2 True
3 True
dtype: bool0 12
2 7
3 10
dtype: int640 12
1 0
2 7
3 10
dtype: int64# Ajout d'une valeur à la serie
#
# VISION NUMPY
# Concatenantion de deux series dont une contenant une seule valeur
# # L = pd.Series([3.5])
# # # s = pd.concat( [s,L] ) # PB !!!! deux fois le même index
# # s = pd.concat( [s,L] , ignore_index=True)
# # display(s)
# # Autre idée :
# L = pd.Series(data=[3.5], index=[len(s)])
# s = pd.concat( [s,L] )
# display(s)
# VISION DICTIONNAIRE
s[len(s)] = 100
display(s)0 12
1 0
2 7
3 10
4 100
dtype: int647.2 Exercice : premières manipulations de DataFrame
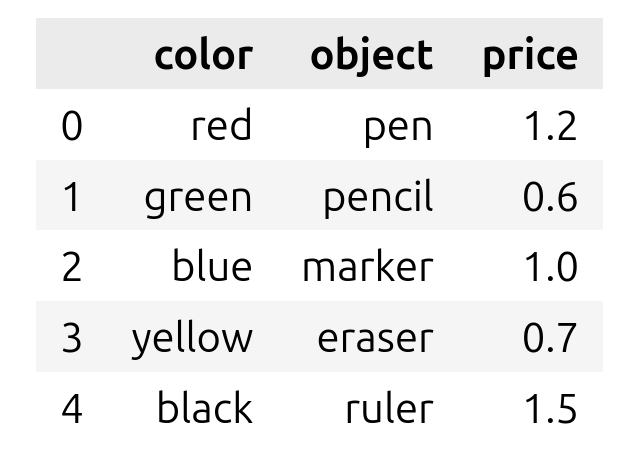
- Construire le DataFrame suivant :
- Afficher les lignes correspondant aux objets dont le prix est supérieur ou égale à 1.
- Modifier le prix de l’objet “eraser” pour le passer à 0.2.
La construction du DataFrame peut se faire en deux étapes. D’abord, on crée un dictionnaire avec les données (colonne par colonne), puis on crée le DataFrame à partir de ce dictionnaire.
| color | object | price | |
|---|---|---|---|
| 0 | red | pen | 1.2 |
| 1 | green | pencil | 0.6 |
| 2 | blue | marker | 1.0 |
| 3 | yellow | eraser | 0.7 |
| 4 | black | ruler | 1.5 |
On va séléctionner les lignes du DataFrame en utilisant un masque :
| color | object | price | |
|---|---|---|---|
| 0 | red | pen | 1.2 |
| 4 | black | ruler | 1.5 |
0     True
1    False
2    False
3    False
4     True
Name: price, dtype: bool
On va modifier la valeur d’une cellule : avec .loc on peut accéder à une cellule en utilisant les indices de la ligne et de la colonne. Pour trouver l’indice de la ligne correspondant à l’objet “eraser”, on peut utiliser un masque.
| color | object | price | |
|---|---|---|---|
| 0 | red | pen | 1.2 |
| 1 | green | pencil | 0.6 |
| 2 | blue | marker | 1.0 |
| 3 | yellow | eraser | 0.2 |
| 4 | black | ruler | 1.5 |
Pour comprendre:
7.3 Exercice : dict de dict en DataFrame
Transformer en dataframe le dictionnaire de dictionnaires suivant:
Une autre forme courante de données est un dictionnaire qui contient plusieurs autres dictionnaires. Si le dictionnaire priciapl est passé au DataFrame, pandas interprétera les clés du dictionnaire extérieur comme étant les colonnes, et les clés intérieures comme étant les indices des lignes :
| Nevada | Ohio | |
|---|---|---|
| 2001 | 2.4 | 1.7 |
| 2002 | 2.9 | 3.6 |
| 2000 | NaN | 1.5 |
7.4 Exercice : régression linéaire
Source : problème 32 de “Python & Pandas et les 36 problèmes de Data Science”, Frédéric Bro et Chantal Remy
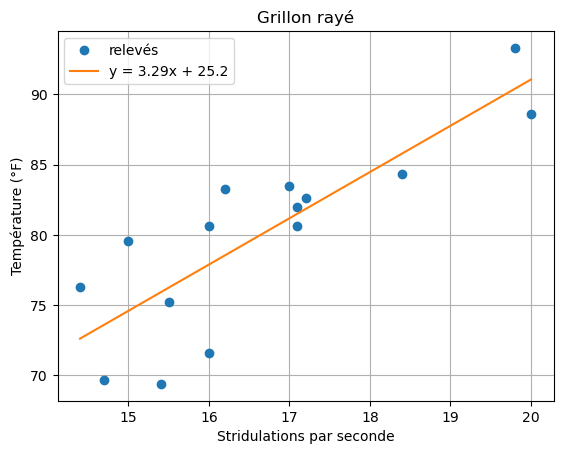
Dans The Song of Insects, George W. Pierce a mesuré la fréquence des stridulations : le son produit par le frottement des ailes : de plusieurs insectes, ainsi que la température à laquelle ces stridulations ont été enregistrées. L’idée est ancienne et connue des naturalistes : un insecte stridulerait d’autant plus vite qu’il fait chaud, au point de pouvoir servir de thermomètre.
Le fichier grillons.csv contient 15 relevés pour le grillon rayé (Nemobius fasciatus) : le nombre de stridulations par seconde et la température en degrés Fahrenheit.
- Charger le fichier et afficher les données.
- Établir par régression linéaire la relation entre la fréquence des stridulations et la température. Autrement dit, en notant \(x\) la fréquence et \(y\) la température, on cherche \(a\) et \(b\) tels que \(y \approx ax+b\). La méthode des moindres carrés consiste à minimiser la somme des carrés des écarts entre valeurs observées et valeurs prédites : \[ (a,b)\qquad\text{tels que}\qquad\sum_{i=1}^n \bigl(y_i - (a x_i + b)\bigr)^2 \quad\text{soit minimale.} \]
- Quelle température prédit-on lorsque le grillon stridule 19 fois par seconde ?
- Vérifier que la droite de régression passe par le point moyen du nuage.
- Calculer le coefficient de corrélation linéaire \(r\) et conclure sur la qualité de l’ajustement.
Bonus. Le fichier cigales.csv contient 19 relevés analogues pour la cigale Tibicen linnei. Refaire la même analyse et comparer les deux espèces : la cigale est-elle un aussi bon thermomètre que le grillon ?
Les coefficients de la droite s’obtiennent avec la fonction polyfit de NumPy, qui prend les abscisses, les ordonnées et le degré du polynôme à ajuster : ici 1. Elle renvoie les coefficients par puissances décroissantes :
7.5 Le grillon rayé
Le fichier est au format français : séparateur ; et virgule décimale. On vérifie les types après lecture, comme toujours.
| stridulations_par_seconde | temperature_F | |
|---|---|---|
| 0 | 20.0 | 88.6 |
| 1 | 16.0 | 71.6 |
| 2 | 19.8 | 93.3 |
| 3 | 18.4 | 84.3 |
| 4 | 17.1 | 80.6 |
| 5 | 15.5 | 75.2 |
| 6 | 14.7 | 69.7 |
| 7 | 17.1 | 82.0 |
| 8 | 15.4 | 69.4 |
| 9 | 16.2 | 83.3 |
| 10 | 15.0 | 79.6 |
| 11 | 17.2 | 82.6 |
| 12 | 16.0 | 80.6 |
| 13 | 17.0 | 83.5 |
| 14 | 14.4 | 76.3 |
stridulations_par_seconde    float64
temperature_F                float64
dtype: objectdroite de régression : y = 3.291 x + 25.23
Prédiction pour un grillon qui stridule 19 fois par seconde :
Seaborn sait calculer et tracer la droite directement, avec regplot :
Pour consulter la documentation d’une fonction, on utilise le point d’interrogation : ?sns.regplot.
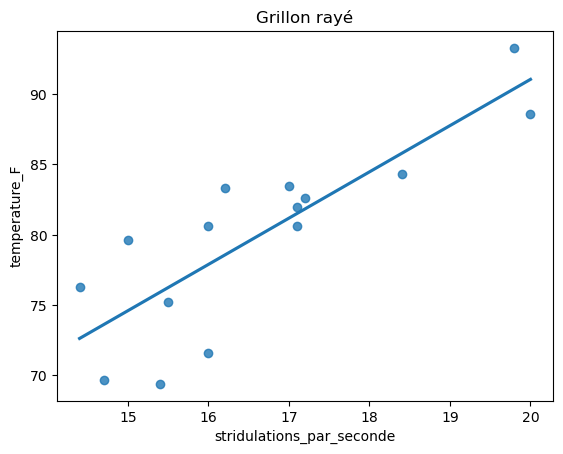
Rappel : la droite de régression passe par le point moyen du nuage. Vérifions-le : l’écart doit être nul, à l’erreur d’arrondi près.
Rappel : la qualité de l’ajustement se mesure par le coefficient de corrélation linéaire \(r\), compris entre \(-1\) et \(1\). Plus \(|r|\) est proche de \(1\), plus les points sont alignés. \[ r = \frac{\sum_{i=1}^n (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum_{i=1}^n (x_i - \bar{x})^2}\sqrt{\sum_{i=1}^n (y_i - \bar{y})^2}} \]
r = 0.835
r² = 0.697
\(r \approx 0{,}84\) : la relation est forte et positive. Environ 70 % de la variation de température est expliquée par la fréquence des stridulations. Le grillon est effectivement un thermomètre acceptable.
7.6 Bonus : et la cigale ?
cigales = pd.read_csv('cigales.csv', sep=';', decimal=',')

xc = cigales['stridulations_par_minute']
yc = cigales['temperature_F']

ac, bc = np.polyfit(xc, yc, 1)
rc = xc.corr(yc)

display(Markdown(f"droite de régression : y = {ac:.3f} x + {bc:.2f}"))
display(Markdown(f"r  = {rc:.3f}"))
display(Markdown(f"r² = {rc**2:.3f}"))
droite de régression : y = -0.154 x + 89.96
r = -0.207
r² = 0.043
fig, (g1, g2) = plt.subplots(1, 2, figsize=(13, 5))

g1.plot(x_points, y_points, 'o')
g1.plot(xx, f(xx), color='crimson')
g1.set(title=f"Grillon rayé  (r = {r:.2f})",
       xlabel='Stridulations par seconde', ylabel='Température (°F)')
g1.grid()

xxc = np.linspace(xc.min(), xc.max(), 101)
g2.plot(xc, yc, 'o')
g2.plot(xxc, ac*xxc + bc, color='crimson')
g2.set(title=f"Cigale Tibicen linnei  (r = {rc:.2f})",
       xlabel='Stridulations par minute', ylabel='Température (°F)')
g2.grid()

plt.tight_layout(); plt.show()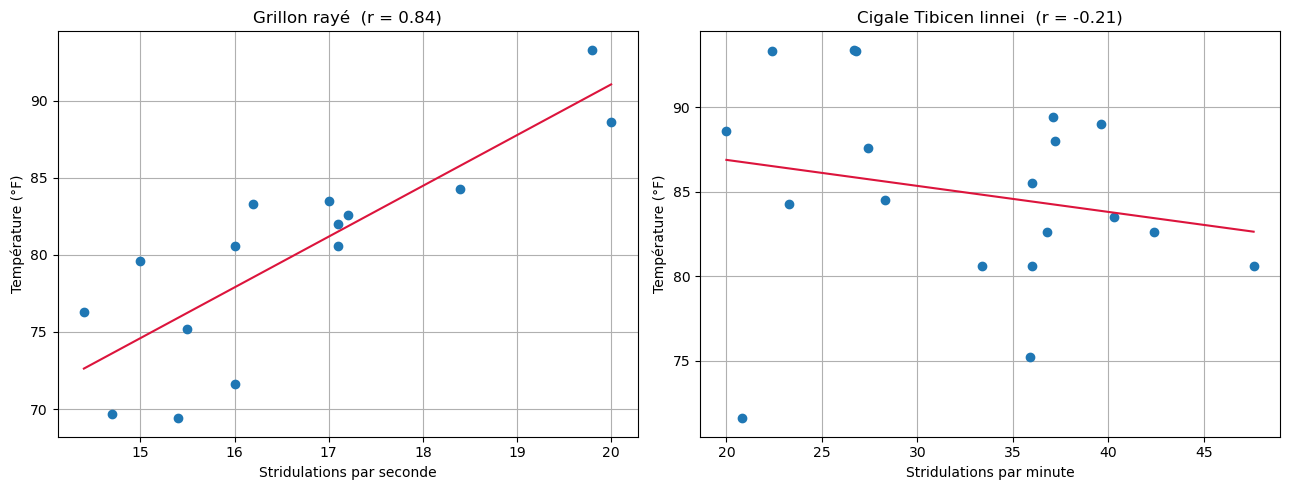
La droite existe toujours ; la relation, non.
polyfit a renvoyé une droite dans les deux cas, sans le moindre avertissement. Mais les deux situations n’ont rien à voir :
| \(r\) | \(r^2\) | pente | |
|---|---|---|---|
| Grillon rayé | \(0{,}84\) | \(0{,}70\) | \(+3{,}29\) |
| Cigale Tibicen linnei | \(-0{,}21\) | \(0{,}04\) | \(-0{,}15\) |
Pour la cigale, \(r^2 \approx 0{,}04\) : la fréquence des stridulations n’explique que 4 % de la variation de température. Pire, la pente est négative : le modèle prétend qu’il fait d’autant plus froid que la cigale stridule vite, ce qui n’a aucun sens biologique. Le nuage de droite est d’ailleurs sans structure visible.
La leçon vaut pour tout votre travail d’analyse : on peut toujours ajuster une droite sur un nuage de points. Regarder le nuage et le coefficient \(r\) avant de conclure n’est pas une formalité, c’est ce qui distingue une analyse d’un calcul.