12 Netflix User Data
L’ensemble de données fu fichier Netflix_Userbase.csv fournit un aperçu d’un échantillon d’utilisateurs de Netflix.
Chaque ligne représente un utilisateur unique, identifié par son ID utilisateur.
L’ensemble de données comprend les colonnes suivantes :
- le type d’abonnement de l’utilisateur (Basic, Standard ou Premium),
- le revenu mensuel généré par son abonnement,
- la date d’inscription à Netflix,
- la date de son dernier paiement et
- le pays dans lequel il se trouve.
Des colonnes supplémentaires ont été incluses pour fournir des informations sur le comportement et les préférences des utilisateurs, comme le type d’appareil.
Source : Kaggle
Disclaimer: l’ensemble de données sert de représentation synthétique et ne reflète pas les données réelles des utilisateurs de Netflix.
12.1 Exercice
- Affichages
- Charger le fichier
Netflix_Userbase.csvdans un DataFrame. - Afficher les 20 premières lignes.
- Combien de ligne et de colonnes contient ce fichier ?
- Quels sont les types des colonnes ?
- Pour chaque colonnes, combien de valeurs différentes contient-elle ?
- Y a-t-il des valeurs manquantes ?
- Charger le fichier
- Modification des données
- Ne garder que les utilisateurs europeens.
- Aggregations/Visualisations
- Afficher le nombre d’utilisateurs par pays.
- Afficher le nombre d’utilisateurs par sexe.
- Afficher le nombre d’utilisateurs par devices utilisés.
- Continuer l’analyse des données en affichant des visualisations qui vous semblent pertinentes en combinant les différentes caractéristiques des utilisateurs.
- Conclusion
- Quels sont les insights que vous avez pu tirer de cette analyse ?
12.1.1 Affichages
| User ID | Subscription Type | Monthly Revenue | Join Date | Last Payment Date | Country | Age | Gender | Device | Plan Duration | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | Basic | 10 | 15-01-22 | 10-06-23 | United States | 28 | Male | Smartphone | 1 Month |
| 1 | 2 | Premium | 15 | 05-09-21 | 22-06-23 | Canada | 35 | Female | Tablet | 1 Month |
| 2 | 3 | Standard | 12 | 28-02-23 | 27-06-23 | United Kingdom | 42 | Male | Smart TV | 1 Month |
| 3 | 4 | Standard | 12 | 10-07-22 | 26-06-23 | Australia | 51 | Female | Laptop | 1 Month |
| 4 | 5 | Basic | 10 | 01-05-23 | 28-06-23 | Germany | 33 | Male | Smartphone | 1 Month |
| 5 | 6 | Premium | 15 | 18-03-22 | 27-06-23 | France | 29 | Female | Smart TV | 1 Month |
| 6 | 7 | Standard | 12 | 09-12-21 | 25-06-23 | Brazil | 46 | Male | Tablet | 1 Month |
| 7 | 8 | Basic | 10 | 02-04-23 | 24-06-23 | Mexico | 39 | Female | Laptop | 1 Month |
| 8 | 9 | Standard | 12 | 20-10-22 | 23-06-23 | Spain | 37 | Male | Smartphone | 1 Month |
| 9 | 10 | Premium | 15 | 07-01-23 | 22-06-23 | Italy | 44 | Female | Smart TV | 1 Month |
| 10 | 11 | Basic | 10 | 16-05-22 | 22-06-23 | United States | 31 | Female | Smartphone | 1 Month |
| 11 | 12 | Premium | 15 | 23-03-23 | 28-06-23 | Canada | 45 | Male | Tablet | 1 Month |
| 12 | 13 | Standard | 12 | 30-11-21 | 27-06-23 | United Kingdom | 48 | Female | Laptop | 1 Month |
| 13 | 14 | Basic | 10 | 01-08-22 | 26-06-23 | Australia | 27 | Male | Smartphone | 1 Month |
| 14 | 15 | Standard | 12 | 09-05-23 | 28-06-23 | Germany | 38 | Female | Smart TV | 1 Month |
| 15 | 16 | Premium | 15 | 07-04-22 | 27-06-23 | France | 36 | Male | Tablet | 1 Month |
| 16 | 17 | Basic | 10 | 24-01-22 | 25-06-23 | Brazil | 30 | Female | Laptop | 1 Month |
| 17 | 18 | Standard | 12 | 18-10-21 | 24-06-23 | Mexico | 43 | Male | Smartphone | 1 Month |
| 18 | 19 | Premium | 15 | 15-02-23 | 23-06-23 | Spain | 32 | Female | Smart TV | 1 Month |
| 19 | 20 | Basic | 10 | 27-05-23 | 22-06-23 | Italy | 41 | Male | Tablet | 1 Month |
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 2500 entries, 0 to 2499
Data columns (total 10 columns):
 #   Column             Non-Null Count  Dtype
---  ------             --------------  -----
 0   User ID            2500 non-null   int64
 1   Subscription Type  2500 non-null   object
 2   Monthly Revenue    2500 non-null   int64
 3   Join Date          2500 non-null   object
 4   Last Payment Date  2500 non-null   object
 5   Country            2500 non-null   object
 6   Age                2500 non-null   int64
 7   Gender             2500 non-null   object
 8   Device             2500 non-null   object
 9   Plan Duration      2500 non-null   object
dtypes: int64(3), object(7)
memory usage: 195.4+ KB
Notre jeu de données contient 2500 lignes (= utilisateurs) et 12 colonnes. 3 colonnes sont de type int, 7 colonnes sont de type object. Notons que les colonnes date sont de type object et devront être converties en datetime pour être exploitées correctement le cas échéant.
Statistiques descriptives pour les colonnes numériques :
| User ID | Monthly Revenue | Age | |
|---|---|---|---|
| count | 2500.00000 | 2500.000000 | 2500.000000 |
| mean | 1250.50000 | 12.508400 | 38.795600 |
| std | 721.83216 | 1.686851 | 7.171778 |
| min | 1.00000 | 10.000000 | 26.000000 |
| 25% | 625.75000 | 11.000000 | 32.000000 |
| 50% | 1250.50000 | 12.000000 | 39.000000 |
| 75% | 1875.25000 | 14.000000 | 45.000000 |
| max | 2500.00000 | 15.000000 | 51.000000 |
Statistiques descriptives pour les colonnes catégorielles :
| Subscription Type | Join Date | Last Payment Date | Country | Gender | Device | Plan Duration | |
|---|---|---|---|---|---|---|---|
| count | 2500 | 2500 | 2500 | 2500 | 2500 | 2500 | 2500 |
| unique | 3 | 300 | 26 | 10 | 2 | 4 | 1 |
| top | Basic | 05-11-22 | 28-06-23 | United States | Female | Laptop | 1 Month |
| freq | 999 | 33 | 164 | 451 | 1257 | 636 | 2500 |
Pour les colonnes dont les valeurs uniques sont inférieures à 20, afficher les possibilités de ces valeurs.
Subscription Type... ['Basic', 'Premium', 'Standard']
Monthly Revenue..... [10, 11, 12, 13, 14, 15]
Country............. ['Australia', 'Brazil', 'Canada', 'France', 'Germany', 'Italy', 'Mexico', 'Spain', 'United Kingdom', 'United States']
Gender.............. ['Female', 'Male']
Device.............. ['Laptop', 'Smart TV', 'Smartphone', 'Tablet']
Plan Duration....... ['1 Month']| count | |
|---|---|
| Subscription Type | |
| Basic | 999 |
| Premium | 733 |
| Standard | 768 |
| count | |
|---|---|
| Monthly Revenue | |
| 10 | 409 |
| 11 | 388 |
| 12 | 455 |
| 13 | 418 |
| 14 | 431 |
| 15 | 399 |
| count | |
|---|---|
| Country | |
| Australia | 183 |
| Brazil | 183 |
| Canada | 317 |
| France | 183 |
| Germany | 183 |
| Italy | 183 |
| Mexico | 183 |
| Spain | 451 |
| United Kingdom | 183 |
| United States | 451 |
| count | |
|---|---|
| Gender | |
| Female | 1257 |
| Male | 1243 |
| count | |
|---|---|
| Device | |
| Laptop | 636 |
| Smart TV | 610 |
| Smartphone | 621 |
| Tablet | 633 |
| count | |
|---|---|
| Plan Duration | |
| 1 Month | 2500 |
# Avec Pandas
df_complet['Country'].value_counts().plot(kind='pie', autopct='%1.2f%%', startangle=90, shadow=False, legend=False)
plt.title('Répartition des utilisateurs par pays');
plt.show()

# Avec Seaborn
# Note: Seaborn n'a pas de fonction native pour les diagrammes circulaires (pie charts)
# sns.countplot(data=df_complet, x='Country');
# plt.title('Répartition des utilisateurs par pays');
# plt.show()

# Avec Plotly
# fig = px.pie(df_complet,
#              names='Country',
#              title='Répartition des utilisateurs par pays'
#              ).update_traces(texttemplate='%{label}<br>%{percent:.2%}',
#                              textposition='outside').show()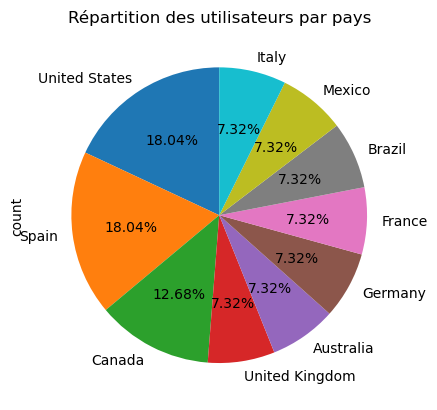
12.1.2 Modification des données
User ID est une colonne qui ne sert pas à grand chose, on peut la supprimer.
filtre = ['United Kingdom', 'Germany', 'France', 'Spain', 'Italy']

# mask =  (df_complet['Country'] in filtre) # erreur
# mask = df_complet['Country']==filtre[0] | df_complet['Country']==filtre[1] | df_complet['Country']==filtre[2] | df_complet['Country']==filtre[3] | df_complet['Country']==filtre[4] # erreur
mask = df_complet['Country'].isin(filtre)
df = df_complet[mask].copy()  # .copy() : on va ajouter des colonnes
df| Subscription Type | Monthly Revenue | Join Date | Last Payment Date | Country | Age | Gender | Device | Plan Duration | |
|---|---|---|---|---|---|---|---|---|---|
| 2 | Standard | 12 | 28-02-23 | 27-06-23 | United Kingdom | 42 | Male | Smart TV | 1 Month |
| 4 | Basic | 10 | 01-05-23 | 28-06-23 | Germany | 33 | Male | Smartphone | 1 Month |
| 5 | Premium | 15 | 18-03-22 | 27-06-23 | France | 29 | Female | Smart TV | 1 Month |
| 8 | Standard | 12 | 20-10-22 | 23-06-23 | Spain | 37 | Male | Smartphone | 1 Month |
| 9 | Premium | 15 | 07-01-23 | 22-06-23 | Italy | 44 | Female | Smart TV | 1 Month |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 2490 | Premium | 13 | 18-07-22 | 11-07-23 | France | 41 | Female | Smartphone | 1 Month |
| 2493 | Premium | 12 | 21-07-22 | 15-07-23 | Spain | 36 | Male | Smart TV | 1 Month |
| 2494 | Basic | 15 | 23-07-22 | 12-07-23 | Italy | 43 | Female | Laptop | 1 Month |
| 2495 | Premium | 14 | 25-07-22 | 12-07-23 | Spain | 28 | Female | Smart TV | 1 Month |
| 2496 | Basic | 15 | 04-08-22 | 14-07-23 | Spain | 33 | Female | Smart TV | 1 Month |
1183 rows × 9 columns
12.1.3 Aggregations/Visualisations
12.1.4 Répartition selon chaque caractéristique
Nous voulons le même tableau : effectifs et pourcentages : pour quatre colonnes différentes. Plutôt que de recopier quatre fois les mêmes instructions, écrivons-les une fois dans une fonction. C’est plus court, et surtout : si l’on veut changer la présentation, il n’y a qu’un seul endroit à corriger.
categorielles = ['Country', 'Gender', 'Device', 'Subscription Type']

def repartition(colonne):
    """Effectifs et pourcentages des modalités d'une colonne."""
    effectifs = df[colonne].value_counts()
    return pd.DataFrame({
        'Nombre'          : effectifs,
        'Pourcentage (%)' : (effectifs / effectifs.sum() * 100).round(1)
    })

for colonne in categorielles:
    display(Markdown(f"**{colonne}**"))
    display(repartition(colonne))
Country
| Nombre | Pourcentage (%) | |
|---|---|---|
| Country | ||
| Spain | 451 | 38.1 |
| United Kingdom | 183 | 15.5 |
| Germany | 183 | 15.5 |
| France | 183 | 15.5 |
| Italy | 183 | 15.5 |
Gender
| Nombre | Pourcentage (%) | |
|---|---|---|
| Gender | ||
| Female | 602 | 50.9 |
| Male | 581 | 49.1 |
Device
| Nombre | Pourcentage (%) | |
|---|---|---|
| Device | ||
| Laptop | 316 | 26.7 |
| Smart TV | 297 | 25.1 |
| Smartphone | 286 | 24.2 |
| Tablet | 284 | 24.0 |
Subscription Type
| Nombre | Pourcentage (%) | |
|---|---|---|
| Subscription Type | ||
| Basic | 474 | 40.1 |
| Premium | 366 | 30.9 |
| Standard | 343 | 29.0 |
Et les quatre camemberts d’un seul coup :
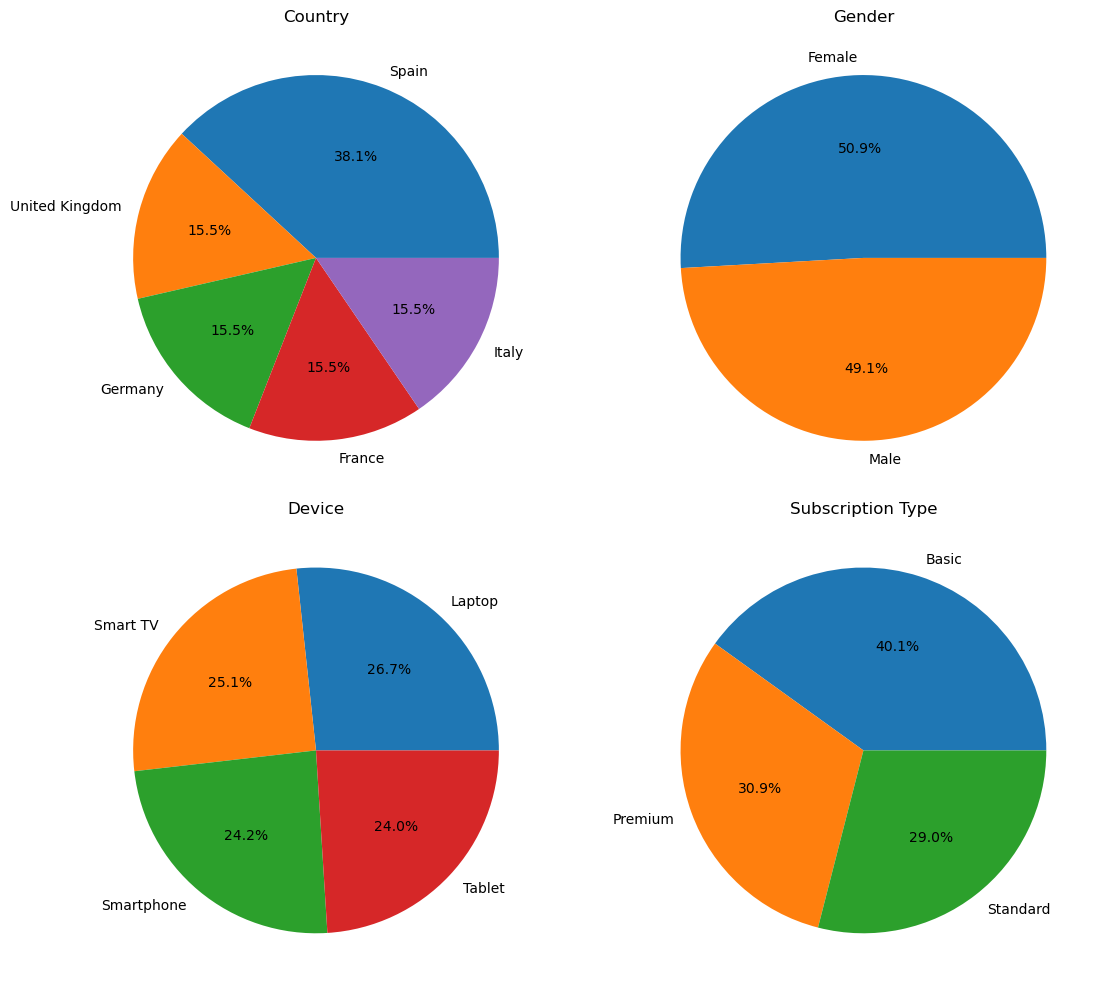
L’Espagne concentre à elle seule 38 % des abonnés européens, les quatre autres pays se partageant le reste à parts presque égales. En revanche, sexe, appareil et formule d’abonnement sont proches de l’équilibre.
12.1.5 L’âge : une variable numérique
L’âge se traite autrement. value_counts() produirait ici un tableau d’une ligne par âge distinct : 25 lignes illisibles, où l’on ne verrait rien. Pour une variable numérique, on résume par ses statistiques et on visualise par un histogramme.
count    1183.0
mean       38.9
std         7.2
min        27.0
25%        33.0
50%        39.0
75%        45.0
max        51.0
Name: Age, dtype: float64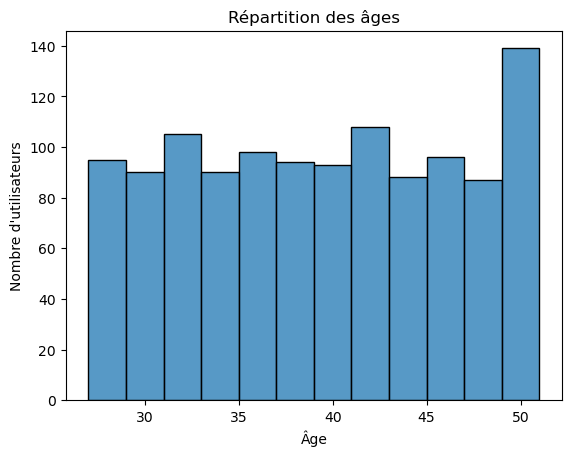
Si l’on tient à un tableau, il faut d’abord regrouper les âges en tranches avec pd.cut :
| Nombre | |
|---|---|
| tranche_age | |
| [25, 30) | 134 |
| [30, 35) | 246 |
| [35, 40) | 241 |
| [40, 45) | 240 |
| [45, 50) | 235 |
| [50, 55) | 87 |
Les abonnés ont entre 27 et 51 ans, assez uniformément répartis entre 30 et 50. Le jeu de données ne contient ni adolescents ni personnes âgées : encore un indice de son caractère synthétique.
12.1.6 Les dates d’inscription et de paiement
Les colonnes Join Date et Last Payment Date ont été lues comme du texte : telles quelles, on ne peut ni les comparer, ni en extraire un mois. Il faut les convertir.
avant conversion : object
exemples : [‘28-02-23’, ‘01-05-23’, ‘18-03-22’]
Le format 15-01-22 est ambigu : jour-mois-année ou mois-jour-année ? Ici c’est le premier, que l’on indique explicitement avec format : il vaut toujours mieux le préciser que laisser pandas deviner.
après conversion : datetime64[ns]
| Join Date | Last Payment Date | |
|---|---|---|
| 2 | 2023-02-28 | 2023-06-27 |
| 4 | 2023-05-01 | 2023-06-28 |
| 5 | 2022-03-18 | 2023-06-27 |
Une fois la colonne en type date, l’accesseur .dt donne accès à l’année, au mois, au jour de la semaine :
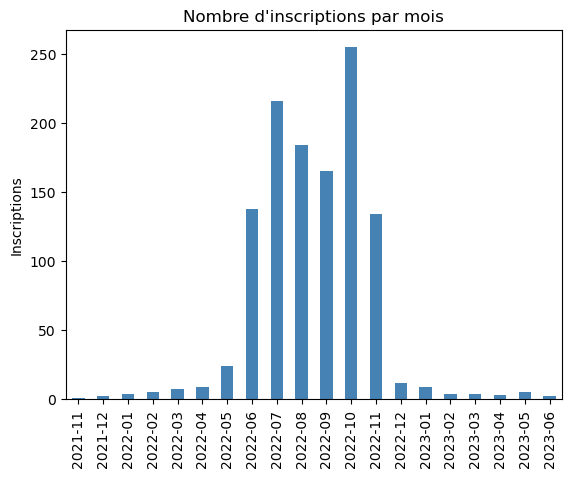
Les inscriptions se concentrent massivement entre juin et novembre 2022 ; avant et après, il n’y en a presque aucune. Là encore, aucune plateforme réelle ne recrute de cette façon : c’est la fenêtre de génération des données.
Enfin, la différence entre deux dates donne une durée, dont on extrait le nombre de jours avec .dt.days :
count    1183.0
mean      307.0
std        65.0
min         8.0
25%       260.0
50%       307.0
75%       356.0
max       574.0
Name: anciennete_jours, dtype: float64
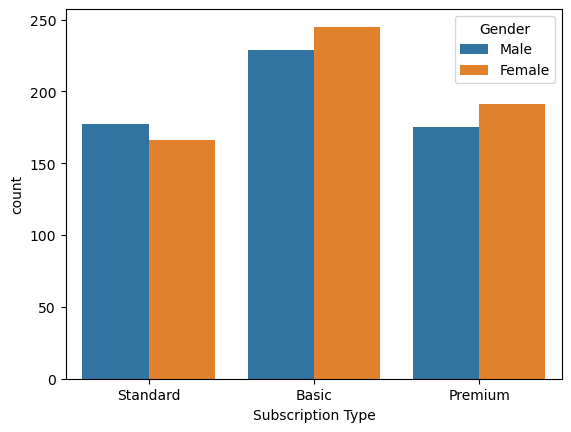
Nombre d’utilisateurs par type d’abonnement et genre
# pd.crosstab(df['Subscription Type'], df['Gender']) # tableau de contingence
# pd.crosstab(df['Subscription Type'], df['Gender'], normalize='index') # pourcentage par ligne
# pd.crosstab(df['Subscription Type'], df['Gender'], normalize='columns') # pourcentage par colonne
pd.crosstab(df['Subscription Type'], df['Gender'], normalize='all') # pourcentage total| Gender | Female | Male |
|---|---|---|
| Subscription Type | ||
| Basic | 0.207101 | 0.193576 |
| Premium | 0.161454 | 0.147929 |
| Standard | 0.140321 | 0.149620 |
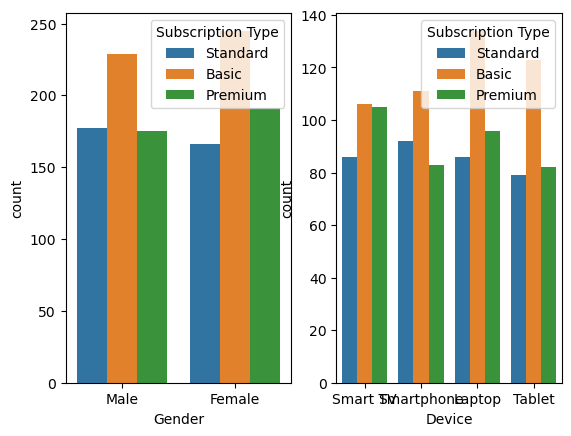
Type d’abonnement par pays, genre et device
| Gender | Female | Male | ||||||
|---|---|---|---|---|---|---|---|---|
| Device | Laptop | Smart TV | Smartphone | Tablet | Laptop | Smart TV | Smartphone | Tablet |
| Country | ||||||||
| France | 29 | 25 | 24 | 13 | 23 | 18 | 23 | 28 |
| Germany | 27 | 26 | 17 | 24 | 36 | 16 | 19 | 18 |
| Italy | 20 | 31 | 20 | 20 | 30 | 15 | 27 | 20 |
| Spain | 56 | 63 | 49 | 65 | 51 | 63 | 53 | 51 |
| United Kingdom | 22 | 16 | 27 | 28 | 22 | 24 | 27 | 17 |
Type d’abonnement par pays et genre
12.1.7 Peut-on tout corréler ? Un contre-exemple
Une idée séduisante pour repérer d’un coup d’œil quelles caractéristiques « vont ensemble » : convertir toutes les colonnes textuelles en nombres, puis calculer la matrice de corrélation. Essayons : et surtout, vérifions ce que le résultat vaut.
# On travaille sur une COPIE : l'encodage détruirait les libellés dont nous avons encore besoin
df_code = df.copy()

for col in df_code.select_dtypes(include='object').columns:
    df_code[col] = df_code[col].astype('category').cat.codes

# on ne garde que les colonnes numériques : les dates et la tranche d'âge
# (de type « catégorie ») n'entrent pas dans une matrice de corrélation
corr = df_code.select_dtypes(include='number').corr()

plt.figure(figsize=(9, 7))
sns.heatmap(corr, annot=True, fmt='.2f', cmap='coolwarm', center=0)
plt.title("Matrice de corrélation sur variables encodées")
plt.show()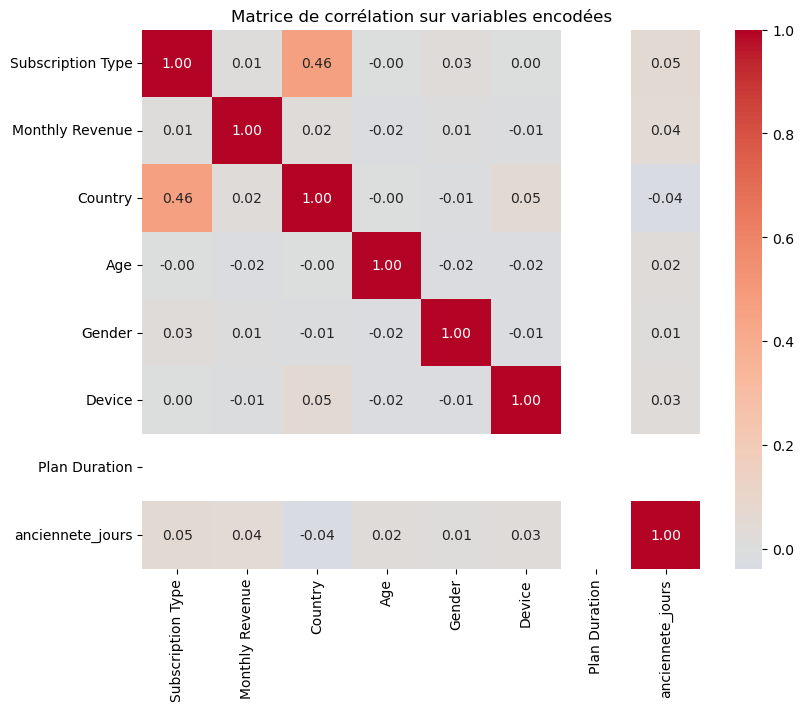
Tous les coefficients sont proches de zéro. La conclusion semble sans appel : aucune caractéristique n’est liée à une autre.
Vérifions cette conclusion par un tableau croisé, en reprenant les libellés d’origine.
| Country | France | Germany | Italy | Spain | United Kingdom |
|---|---|---|---|---|---|
| Subscription Type | |||||
| Basic | 19.7 | 81.4 | 96.2 | 24.4 | 1.6 |
| Premium | 80.3 | 1.6 | 2.2 | 47.0 | 0.0 |
| Standard | 0.0 | 16.9 | 1.6 | 28.6 | 98.4 |
La matrice se trompait complètement.
Le tableau croisé montre une association massive : 96 % des abonnés italiens ont une formule Basic, 98 % des britanniques une formule Standard et aucun une Premium, tandis qu’en France 80 % sont en Premium et aucun en Standard. L’écart atteint 98 points de pourcentage : le pays détermine presque entièrement le type d’abonnement.
Et la corrélation correspondante valait \(0{,}02\).
Pourquoi ? Le coefficient de Pearson mesure si deux nombres varient ensemble de façon linéaire. En codant les pays France=0, Germany=1, Italy=2, Spain=3, United Kingdom=4, on lui demande si le numéro de l’abonnement croît proportionnellement au numéro du pays : question dépourvue de sens, puisque l’ordre des pays est celui de l’alphabet. L’association est bien réelle, mais elle n’est pas linéaire dans un ordre arbitraire : le coefficient ne peut pas la voir.
Le piège est d’autant plus dangereux que le calcul n’émet aucun avertissement et produit un graphique d’apparence professionnelle.
Le problème touche même les variables ordinales, dont les modalités ont pourtant un ordre naturel. cat.codes classe par ordre alphabétique, ce qui donne ici Basic=0, Premium=1, Standard=2 : la formule la plus chère se retrouve au milieu.
alphabetique = df['Subscription Type'].astype('category').cat.codes
naturel      = df['Subscription Type'].map({'Basic': 0, 'Standard': 1, 'Premium': 2})

display(Markdown(f"codage alphabétique (Basic, Premium, Standard) : r = {alphabetique.corr(df['Monthly Revenue']): .4f}"))
display(Markdown(f"ordre naturel       (Basic, Standard, Premium) : r = {naturel.corr(df['Monthly Revenue']): .4f}"))
codage alphabétique (Basic, Premium, Standard) : r = 0.0145
ordre naturel (Basic, Standard, Premium) : r = 0.0458
Le coefficient triple simplement parce qu’on a rangé les modalités dans le bon ordre. Si vous encodez une variable ordinale, faites-le explicitement avec un dictionnaire, jamais avec cat.codes.
12.1.8 La bonne façon de faire
Pour deux variables catégorielles, l’outil adapté est le tableau croisé normalisé, que nous avons déjà utilisé plus haut. Il se lit directement et ne repose sur aucun codage arbitraire.
Type d’abonnement selon Device (% par colonne)
| Device | Laptop | Smart TV | Smartphone | Tablet |
|---|---|---|---|---|
| Subscription Type | ||||
| Basic | 42.4 | 35.7 | 38.8 | 43.3 |
| Premium | 30.4 | 35.4 | 29.0 | 28.9 |
| Standard | 27.2 | 29.0 | 32.2 | 27.8 |
Type d’abonnement selon Gender (% par colonne)
| Gender | Female | Male |
|---|---|---|
| Subscription Type | ||
| Basic | 40.7 | 39.4 |
| Premium | 31.7 | 30.1 |
| Standard | 27.6 | 30.5 |
Contrairement au pays, ni l’appareil ni le sexe ne structurent le type d’abonnement : d’une colonne à l’autre, le profil reste le même, environ 40 % de Basic, 30 % de Premium, 29 % de Standard. C’est précisément cette stabilité d’une colonne à l’autre qui signale l’absence de lien, et non le fait que les trois formules soient à égalité. Ici, l’absence de lien est une vraie conclusion, lisible sans ambiguïté.
Un mot sur ces données. Une répartition aussi tranchée : 98 % d’une seule formule dans un pays, 0 % d’une autre : ne s’observe jamais sur des abonnés réels. C’est un artefact de génération : le jeu de données est synthétique, comme l’indique l’avertissement en tête de ce notebook.
Conservez ce réflexe pour vos propres analyses : un résultat trop propre doit déclencher une vérification, pas une conclusion.