4 Introduction aux structures de données pandas : les Series (tableaux unidimensionnels)
Nous allons découvrir deux structures de données de base de la bibliothèque Pandas : les Series, les DataFrames (éventuellement les Index).
Commençons par importer la bibliothèque Pandas (et la bibliotèque NumPy) avec les alias classiques pd et np :
Un objet Series (une série) est un tableau à une dimension capable de stocker n’importe quel type de données (entiers, chaînes de caractères, flottants, objets Python, etc.).
Elle se distingue d’un ndarray NumPy par son indexation. Dans Numpy, l’indexation est implicite (pour accéder à une donnée on indique la position). Avec une Series, on peut bien sûr utiliser un indice de position mais on peut surtout faire appel à des indices plus explicites identifiés par des labels. Ces labels peuvent être des chaînes de caractères, des dates ou encore des nombres et peuvent être non ordonnés et non uniques.
5 Création d’une Series
On peut crééer une série à partir
- d’une liste de valeurs ou d’un tableau NumPy (les labels sont alors générées automatiquement)
- deux listes : une liste (ou array NumPy) de valeurs et une liste de labels
- d’un dictionnaire
5.1 À partir d’une liste/array de valeurs
0    0.25
1    0.50
2    0.75
3    1.00
dtype: float64
On voit qu’une Series contient une séquence de valeurs et une séquence d’indices (ici générés automatiquement). Pour accéder à ces deux séquences, on peut utiliser les attributs values et index de la Series.
array([0.25, 0.5 , 0.75, 1. ])RangeIndex(start=0, stop=4, step=1)On peut accéder à un élément de la série par son index (qui est un entier crée automatiquemnt ou passé explicitement):
5.2 À partir de deux listes/array : une liste de valeurs et une liste d’index associés
Suisse       8
France      70
USA        320
Chine     1200
dtype: int64array([ 8, 70, 320, 1200])Index(['Suisse', 'France', 'USA', 'Chine'], dtype='object')On peut accéder à une valeur en utilisant son label, un peu comme dans un dictionnaire.
Les objets Index (i.e. les labels) sont immutables et ne peuvent donc pas être modifiés par l’utilisateur. On peut accéder à une label selon sa position:
Un Index peut contenir des étiquettes dupliquées. Les sélections avec des étiquettes en double renverront toutes les occurrences de cette étiquette.
Suisse       8
France      70
USA        320
Chine     1200
France    2000
dtype: int64
France 70
France 2000
dtype: int645.3 À partir d’un dictionnaire { label1: valeur1, label2: valeur2, ...}
France      70
USA        320
Suisse       8
Chine     1200
dtype: int64Attention, comme les éléments d’un dictionnaire ne sont pas ordonnés, dans l’objet Series les entrées seront ordonnées selon l’ordre d’ajout. On peut ensuite ordonner les éléments de la Series en utilisant la méthode sort_index().
6 Slicing \(\leadsto\) sélection avec loc et iloc
Pour l’indexation par étiquettes des DataFrame sur les lignes, les opérateurs d’indexation spéciaux loc et iloc permettent de sélectionner un sous-ensemble de lignes et de colonnes d’un DataFrame avec une notation de type NumPy en utilisant soit des étiquettes d’axes (loc), soit des entiers (iloc).
Une serie peut être vue comme un dictionnaire ordonné ou comme une liste, ainsi on peut accéder à un élément en utilisant son label ou son indice.
Considérons le cas suivant :
a    0.25
b    0.50
c    0.75
d    1.00
dtype: float64
# Si on voit la Series comme un dictionnaire :
display(data['b']) # On peut accéder à un élément par son index
display('a' in data) # On peut tester l'existence d'une clé
display(data.keys()) # On peut récupérer les index
display(list(data.items())) # On peut récupérer les couples (index, valeur)
data['e'] = 1.25 # On peut ajouter un élément
display(data)0.5TrueIndex(['a', 'b', 'c', 'd'], dtype='object')[('a', 0.25), ('b', 0.5), ('c', 0.75), ('d', 1.0)]a 0.25
b 0.50
c 0.75
d 1.00
e 1.25
dtype: float64# Si on voit la Series comme un tableau numpy/liste dont les indices peuvent être des chaînes :
display(data[1]) # On peut accéder à un élément par sa position
display(data[ ['a', 'e'] ]) # les éléments dont les indices sont 'a' et 'e'
display(data[(data > 0.3) & (data < 0.8)]) # masque : `&` pour le `and`, `|` pour le `or` et `~` pour le `not` ; parenthèses obligatoires/tmp/ipykernel_482666/2399729980.py:3: FutureWarning: Series.__getitem__ treating keys as positions is deprecated. In a future version, integer keys will always be treated as labels (consistent with DataFrame behavior). To access a value by position, use `ser.iloc[pos]`
display(data[1]) # On peut accéder à un élément par sa position0.5a 0.25
e 1.25
dtype: float64b 0.50
c 0.75
dtype: float64Cette double vision des indices peut être source de confusion avec le slicing :
- si on utilise des indices automatiques, le slicing se fait comme dans Numpy (premier inclus, dernier exclu),
- si on utilise comme indices des labels, le dernier est aussi inclus.
a    0.25
b    0.50
c    0.75
d    1.00
e    1.25
dtype: float64a 0.25
b 0.50
dtype: float64a 0.25
b    0.50
c    0.75
dtype: float64Pire, si les indices sont des entiers, on ne sait pas si pandas interprètes ces nombre comme des indices ou des labels pour le slicing :
1000    0.25
1100    0.50
1200    0.75
1300    1.00
dtype: float64display(data2[0:2]) # slicing explicite donc on prend les éléments de la poisition 0 incluse à la position 2 excluse
display(data2[1000:1200]) # slicing qui semble implicite, mais comme les indices sont des entiers, il agit comme un slicing explicite donc on prend les éléments de 1000 inclus à 1200 exclu1000 0.25
1100 0.50
dtype: float64Series([], dtype: float64)La solution : loc et iloc :
locpermet d’accéder aux éléments en utilisant les labels,ilocpermet d’accéder aux éléments en utilisant les indices numériques.
7 Ajouter des éléments à une Series / Fusionner deux Series
Pour ajouter un élément à une Series, on peut utiliser la méthode concat() :
Suisse       8
France      70
USA        320
Chine     1200
France       1
USA          4
Suisse       3
Italie      10
dtype: int64
On note que certaines labels sont dupliquées, ce qui est autorisé dans une Series.
8 Supprimer des éléments à une Series
Pour supprimer un élément d’une Series, on peut utiliser la méthode drop() et spécifier l’index de l’élément à supprimer.
Par default la méthode drop ne modifie pas la Series, mais renvoie une nouvelle Series sans l’élément supprimé. Pour modifier la Series, on peut utiliser l’argument inplace=True.
9 Tableau comparatif entre list, dict, numpy.ndarray et pandas.Series
| Aspect | list |
dict |
np.ndarray |
pd.Series |
|---|---|---|---|---|
| Type d’accès | Par indice entier | Par clé (=label) | Par indice entier | Par label (loc) ou position (iloc) |
| Slicing | ✔️ lst[1:3] |
❌ Impossible | ✔️ arr[1:3] |
✔️ s.iloc[1:3] (par positions) ✔️ s.loc["a":"c"] (par labels) |
| Homogénéité | ❌ Hétérogène permis | ❌ Hétérogène permis | ✔️ Homogène | ✔️ Souvent homogène |
| Opérations vectorisées | ❌ Non | ❌ Non | ✔️ Oui | ✔️ Oui |
| Utilisation typique | Séquences | Mapping clé→valeur | Calcul scientifique | Données tabulaires 1D indexées |
⚠️ Note importante :
iloc[1:4]exclut la fin → l’élément d’index 4 est non inclus.loc["b":"d"]inclut la fin → l’élément de label “d” est inclus.
10[20, 30, 40]1010array([20, 30, 40])# PANDAS SERIES
# =====================================
import pandas as pd
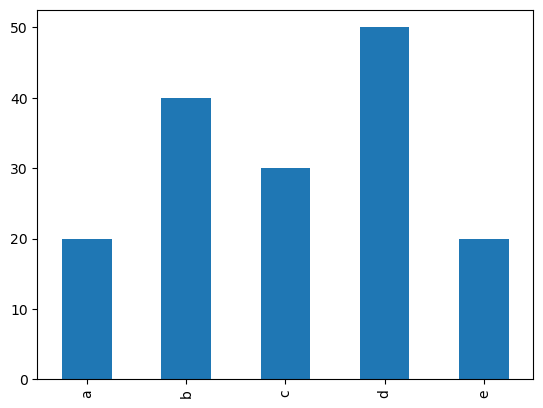
s = pd.Series([20, 40, 30, 50, 20],
index=["a", "b", "c", "d", "e"])
# Accès
display(s.iloc[0]) # par position
display(s["a"]) # par label
# Slicing
display(s.iloc[1:4]) # par positions
display(s.loc["b":"d"]) # par labels (INCLUSIF !)2020b 40
c 30
d 50
dtype: int64b 40
c 30
d 50
dtype: int6410 Représentation graphique d’une Series
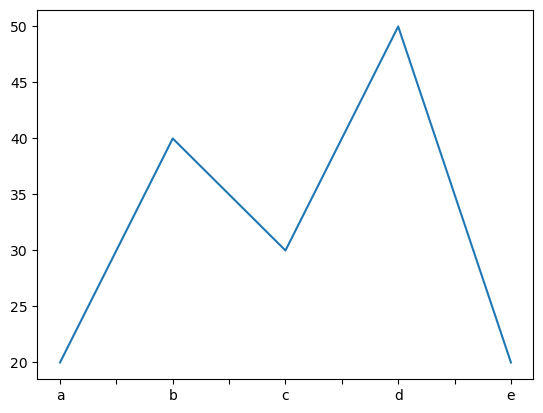
On peut appliquer la méthode plot() directement à une Serie :
Le code équivalent avec matplotlib serait:
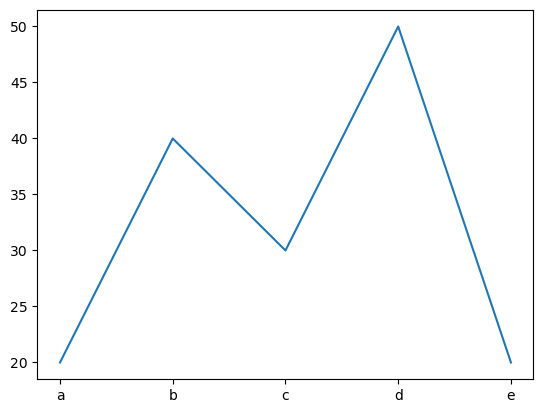
On peut personnaliser le graphique en utilisant les arguments de la méthode plot() de pandas ou en utilisant les fonctions de matplotlib après avoir récupéré les données de la Series.
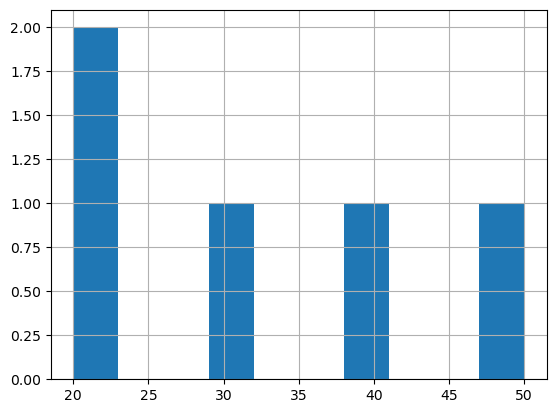
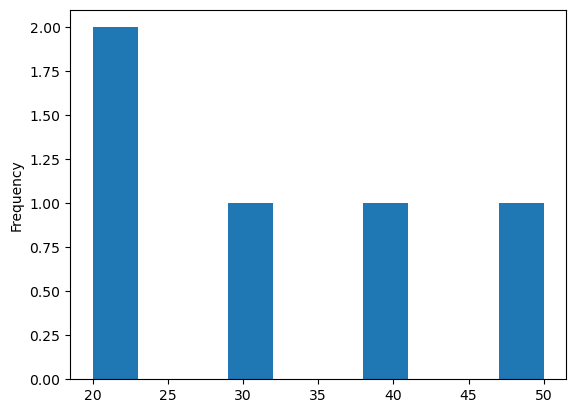
On peut tracer différents types de graphiques en utilisant l’argument kind de la méthode plot() : bar pour un graphique en barres, hist pour un histogramme, box pour un diagramme en boîte, etc.
Ou encore avec plotly :
import plotly.express as px

# Pour la génération automatique de graphiques interactifs dans le polycopié
import plotly.io as pio
import os
if os.getenv("QUARTO_OUTPUT_FORMAT") is not None:
    # Export Quarto HTML
    pio.renderers.default = "iframe_connected"
else:
    # Notebook interactif
    pio.renderers.default = "notebook_connected"

px.bar(x=s.index, y=s.values)