9 🛒 Ventes et ☔ pluie : agréger, c’est choisir
Les chapitres précédents ont présenté la mécanique de l’agrégation : groupby, pivot_table, crosstab. Cet exercice porte sur autre chose : la lecture du résultat.
Vous allez constater, sur deux jeux de données différents, qu’une même question posée à des données identiques reçoit des réponses opposées selon la grandeur que l’on choisit d’agréger. Agréger n’est pas une opération neutre : c’est déjà une décision d’analyse.
9.1 Exercice
9.1.1 Partie A : Ventes de deux magasins
Le fichier ventes.csv donne, pour deux magasins et quatre trimestres, les quantités vendues de trois produits et leur prix unitaire.
- Charger le fichier et vérifier le type de chaque colonne avant toute chose.
- Ajouter une colonne
montant, égale à la quantité multipliée par le prix unitaire. - Quel magasin réalise le plus gros chiffre d’affaires ?
- Croiser magasin et produit : quel produit porte le chiffre d’affaires de chaque magasin ?
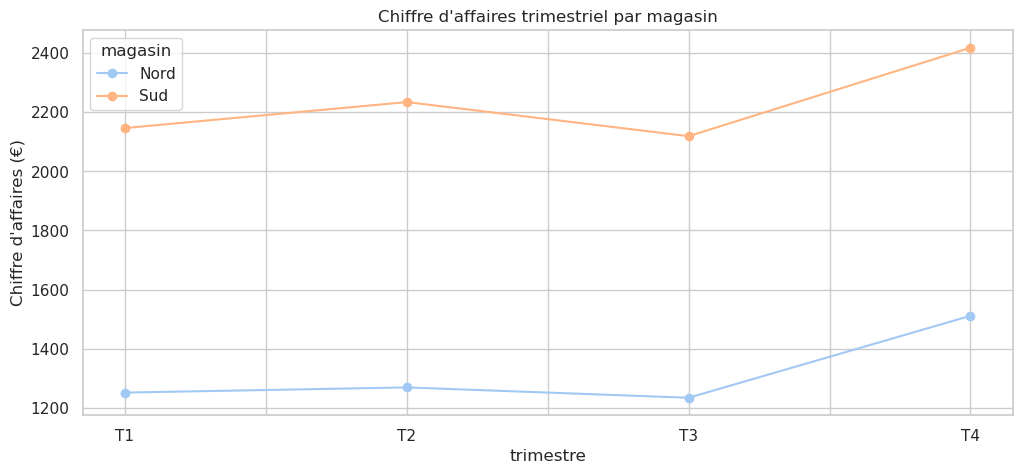
- Tracer l’évolution du chiffre d’affaires par trimestre pour chaque magasin.
- Quel magasin vend le plus d’articles ? Comparer avec la réponse de la question 3 et commenter.
9.1.2 Partie B : Pluviométrie de trois villes
Le fichier pluviometrie.csv donne, pour Brest, Paris et Nice, la hauteur de pluie et le nombre de jours de pluie de chaque mois.
- Charger le fichier.
- Classer les trois villes par cumul annuel de pluie.
- Classer les trois villes par nombre de jours de pluie.
- Comparer les deux classements. Que peut-on en conclure ?
- Calculer la hauteur moyenne de pluie par jour de pluie dans chaque ville.
- Construire un tableau croisé station × mois. Attention à l’ordre des mois.
- Pour chaque ville, déterminer le mois le plus arrosé.
Sur les données. Les ventes sont fictives. Pour la pluviométrie, les totaux annuels sont proches des normales publiées par Météo-France (Brest ≈ 1200 mm, Nice ≈ 800 mm, Paris ≈ 640 mm), mais la répartition mensuelle a été reconstruite pour les besoins de l’exercice : ne citez pas ces chiffres comme des relevés officiels.
10 Partie A : Ventes de deux magasins
10.1 1. Charger le fichier et vérifier les types
Premier réflexe, avant même de lire les données : regarder à quoi ressemble le fichier. Ici le séparateur est ; et le marqueur décimal est la virgule.
magasin;trimestre;produit;quantite;prix_unitaire
Nord;T1;stylo;400;1,50
Nord;T1;cahier;120;3,20
Nord;T1;classeur;30;8,90
Nord;T2;stylo;420;1,50
Nord;T2;cahier;130;3,20
Nord;T2;classeur;25;8,90
Nord;T3;stylo;380;1,50
Nord| magasin | trimestre | produit | quantite | prix_unitaire | |
|---|---|---|---|---|---|
| 0 | Nord | T1 | stylo | 400 | 1.5 |
| 1 | Nord | T1 | cahier | 120 | 3.2 |
| 2 | Nord | T1 | classeur | 30 | 8.9 |
| 3 | Nord | T2 | stylo | 420 | 1.5 |
| 4 | Nord | T2 | cahier | 130 | 3.2 |
magasin           object
trimestre         object
produit           object
quantite           int64
prix_unitaire    float64
dtype: object
prix_unitaire est bien en float64. Si nous avions oublié decimal=',', la colonne aurait été lue comme du texte et toute la suite aurait été fausse : c’est la vérification à ne jamais sauter.
10.2 2. Ajouter la colonne montant
10.3 3. Quel magasin réalise le plus gros chiffre d’affaires ?
10.4 4. Quel produit porte chaque magasin ?
| produit | cahier | classeur | stylo | All |
|---|---|---|---|---|
| magasin | ||||
| Nord | 1632.0 | 1157.0 | 2475.0 | 5264.0 |
| Sud | 1360.0 | 6630.5 | 930.0 | 8920.5 |
| All | 2992.0 | 7787.5 | 3405.0 | 14184.5 |
Plus lisible en pourcentage de chaque ligne :
| produit | cahier | classeur | stylo |
|---|---|---|---|
| magasin | |||
| Nord | 31.0 | 22.0 | 47.0 |
| Sud | 15.2 | 74.3 | 10.4 |
La lecture est immédiate : le Sud réalise l’essentiel de son chiffre d’affaires sur les classeurs, le Nord est beaucoup plus équilibré, avec une part importante de stylos.
10.5 5. Évolution trimestrielle
| magasin | Nord | Sud |
|---|---|---|
| trimestre | ||
| T1 | 1251.0 | 2147.0 |
| T2 | 1268.5 | 2235.0 |
| T3 | 1233.5 | 2119.5 |
| T4 | 1511.0 | 2419.0 |
10.6 6. Et en nombre d’articles ?
Jusqu’ici nous avons agrégé les euros. Agrégeons maintenant les articles :
| articles | chiffre_affaires | panier_moyen | |
|---|---|---|---|
| magasin | |||
| Nord | 2290 | 5264.0 | 2.30 |
| Sud | 1790 | 8920.5 | 4.98 |
Plus d’articles vendus : Nord
Plus gros chiffre d’affaires : Sud
Les deux classements s’opposent. Le magasin Nord vend 2 290 articles contre 1 790 pour le Sud, mais le Sud réalise un chiffre d’affaires de 8 920,50 € contre 5 264 € pour le Nord.
Il n’y a aucune contradiction : le Nord écoule des stylos à 1,50 €, le Sud des classeurs à 8,90 €. La dernière colonne le résume : le prix moyen d’un article vendu est près de deux fois plus élevé au Sud.
La question « quel est le meilleur magasin ? » n’a donc pas de réponse tant qu’on n’a pas dit ce qu’on mesure. C’est à l’analyste de le préciser, pas à groupby.
11 Partie B : Pluviométrie de trois villes
11.1 1. Charger le fichier
11.2 2. et 3. Deux classements
| cumul_mm | jours | |
|---|---|---|
| station | ||
| Brest | 1225 | 162 |
| Nice | 797 | 63 |
| Paris | 655 | 111 |
Classement par hauteur de pluie : Brest > Nice > Paris
Classement par jours de pluie : Brest > Paris > Nice
11.3 4. Comparaison des deux classements
Paris et Nice échangent leur place.
- En hauteur de pluie, il tombe nettement plus d’eau à Nice qu’à Paris : environ 800 mm contre 655 mm.
- En nombre de jours, c’est l’inverse : il pleut à Paris environ 111 jours par an, contre 63 à Nice.
« Il pleut plus à Paris qu’à Nice » est donc vrai et faux à la fois, selon la grandeur choisie. Les deux affirmations décrivent la même réalité : à Nice il pleut rarement, mais fort ; à Paris il pleut souvent, mais peu.
Brest, elle, est première dans les deux classements : il n’y a pas toujours d’ambiguïté, mais il faut toujours vérifier.
11.4 5. L’intensité des pluies
Le rapport des deux grandeurs donne directement la hauteur moyenne tombée un jour de pluie :
| cumul_mm | jours | mm_par_jour_de_pluie | |
|---|---|---|---|
| station | |||
| Nice | 797 | 63 | 12.7 |
| Brest | 1225 | 162 | 7.6 |
| Paris | 655 | 111 | 5.9 |
Une pluie niçoise apporte en moyenne plus du double d’une pluie parisienne. C’est cette troisième grandeur, construite à partir des deux premières, qui réconcilie les classements et explique le phénomène.
11.5 6. Tableau croisé station × mois
Première tentative, et premier piège :
| mois | août | avril | décembre | février | janvier | juillet | juin | mai | mars | novembre | octobre | septembre |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| station | ||||||||||||
| Brest | 55.0 | 85.0 | 165.0 | 110.0 | 150.0 | 50.0 | 55.0 | 75.0 | 100.0 | 155.0 | 140.0 | 85.0 |
| Nice | 20.0 | 70.0 | 95.0 | 45.0 | 70.0 | 12.0 | 35.0 | 45.0 | 40.0 | 140.0 | 150.0 | 75.0 |
| Paris | 60.0 | 52.0 | 58.0 | 45.0 | 50.0 | 60.0 | 55.0 | 65.0 | 48.0 | 52.0 | 62.0 | 48.0 |
Les mois sont rangés par ordre alphabétique : août, avril, décembre… Pandas ne peut pas deviner qu’il s’agit d’un calendrier. Il faut le lui dire, en déclarant la colonne comme une variable catégorielle ordonnée :
calendrier = ["janvier","février","mars","avril","mai","juin",
              "juillet","août","septembre","octobre","novembre","décembre"]

pluie['mois'] = pd.Categorical(pluie['mois'], categories=calendrier, ordered=True)

croise = pluie.pivot_table(index='station', columns='mois', values='pluie_mm', observed=True)
croise| mois | janvier | février | mars | avril | mai | juin | juillet | août | septembre | octobre | novembre | décembre |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| station | ||||||||||||
| Brest | 150.0 | 110.0 | 100.0 | 85.0 | 75.0 | 55.0 | 50.0 | 55.0 | 85.0 | 140.0 | 155.0 | 165.0 |
| Nice | 70.0 | 45.0 | 40.0 | 70.0 | 45.0 | 35.0 | 12.0 | 20.0 | 75.0 | 150.0 | 140.0 | 95.0 |
| Paris | 50.0 | 45.0 | 48.0 | 52.0 | 65.0 | 55.0 | 60.0 | 60.0 | 48.0 | 62.0 | 52.0 | 58.0 |
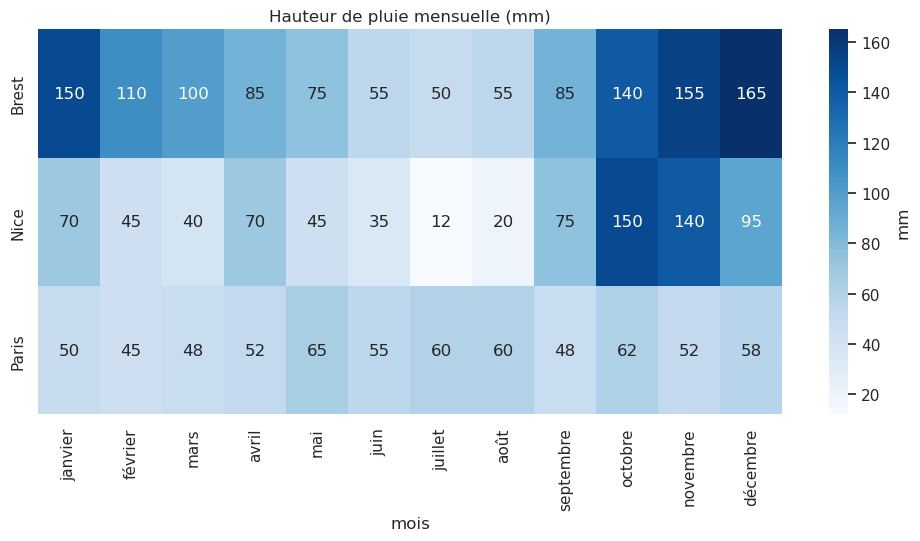
La carte de chaleur rend les trois régimes immédiatement visibles : Brest arrosée toute l’année avec un creux estival, Paris remarquablement régulière, et Nice avec un été quasi sec suivi d’un automne très violent.
11.6 7. Le mois le plus arrosé de chaque ville
12 Conclusion
Ce que cet exercice voulait montrer
Dans les deux cas, le code était trivial : un groupby et une somme. C’est l’interprétation qui demandait du travail.
- Partie A : « quel est le meilleur magasin ? » dépend de ce qu’on somme, les euros ou les articles.
- Partie B : « où pleut-il le plus ? » dépend de ce qu’on somme, les millimètres ou les jours.
Retenez le réflexe : avant d’agréger, demandez-vous quelle question vous posez réellement, et après avoir agrégé, demandez-vous si une autre grandeur donnerait une autre réponse. C’est précisément ce qu’on attend de vous à l’examen : non pas produire un tableau, mais dire ce qu’il signifie.